屠榜海外的「牛来」真身揭晓!智谱 GLM-5.3-Flash 开源:320B 大模型,价格只有前代 1/10
前阵子,一个代号 ox-alpha(中文社区昵称“牛来“)的神秘模型,在 OpenRouter、OpenCode 两大海外 AI 平台杀疯了:登顶调用榜、刷爆双平台历史 Token 调用纪录,甚至终结…
📑 本页目录
前阵子,一个代号 ox-alpha(中文社区昵称“牛来”)的神秘模型,在 OpenRouter、OpenCode 两大海外 AI 平台杀疯了:登顶调用榜、刷爆双平台历史 Token 调用纪录,甚至终结了 DeepSeek 在 OpenCode 长达 56 天的霸榜地位(据社区统计与媒体报道,累计 Token 调用量高达 62T)。圈内人都在猜——这到底是谁家的模型?
真身揭晓:它正是智谱 AI 于 8 月 26 日正式发布开源的 GLM-5.3-Flash。
本文关键参数与价格均已对照智谱官方(ModelScope 模型卡、GitHub 仓库、Z.AI 官方文档)核实,截至 2026-08-27。
一、这是什么?
GLM-5.3-Flash 是 GLM-5 系列首款原生多模态基座模型,也是智谱当下最开放、性价比最高的旗舰——用 MoE 稀疏架构实现了“超大模型规模、小模型推理成本”:
- 320B 总参数,单次只激活 18B,推理成本压到极致
- 原生图文视频理解,从底层融合多模态能力
- 100 万 token 超长上下文,一次能读近 70 万字
- MIT 开源协议,权重全开放,可商用可二改
- API 价格约前代 GLM-5.3 的 1/10(官方口径)
一句话:以前要花大价钱才能用到的旗舰能力,现在白菜价开源给你。
二、核心硬核参数,一表看懂
| 项目 | 详细参数 |
|---|---|
| 总参数量 | 320B(3200 亿) |
| 单 Token 激活参数 | 18B(激活比例仅 5.6%) |
| 核心架构 | MoE 混合专家 + 稀疏注意力 + 线性注意力双轨混合 |
| 上下文窗口 | 100 万 token(1,048,576) |
| 多模态能力 | 原生支持文本、图片、视频、视觉文档解析 |
| 训练数据 | 30T tokens 多模态高质量语料 |
| 模型层数 | 45 层(相较 GLM-4.5 的 92 层近乎减半) |
| 开源协议 | MIT,模型权重全面开放 |
这次架构是重新设计的,不是简单阉割。注意力机制上做了大胆拆分:线性注意力负责捕捉局部依赖,稀疏注意力轻量召回全局关键信息,专治长上下文场景的计算爆炸。
对比前代 GLM-5.3:注意力计算量降低 3.01 倍,KV Cache 缓存占用缩减 4.44 倍——处理大型代码库、超长合同、多步骤 Agent 任务时,推理成本和硬件压力大幅下降。
还有个细节值得一提:匿名测试期间的全部流量,都是由数万张国产芯片集群承载的(官方口径),国产算力第一次大规模扛住前沿大模型的高并发负载。
三、三大核心亮点,重新定义使用体验
1. 原生多模态 + 编程 Agent 闭环
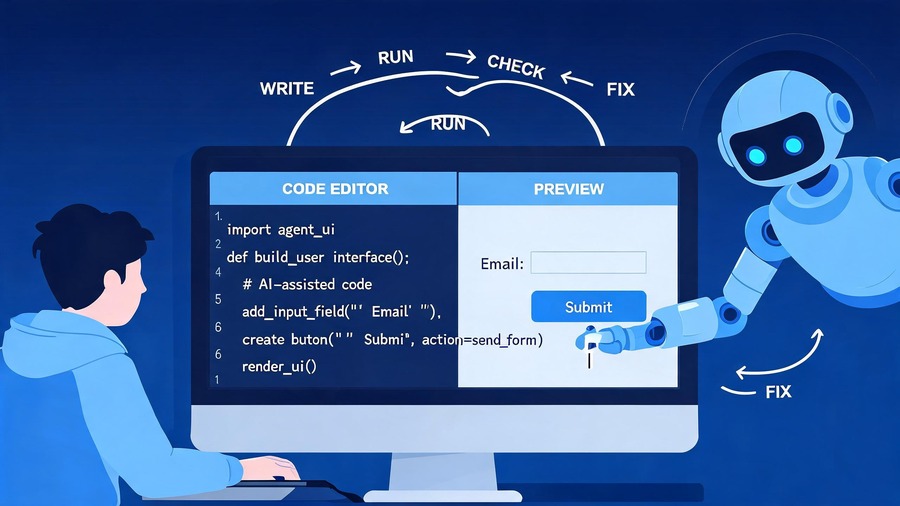
不是文本模型外挂视觉模块,而是从底层融合图文视频理解。最亮眼的是编程 Agent 闭环:模型能直接读取界面截图、程序渲染结果、交互报错反馈,自主完成**“编写代码 → 运行查看效果 → 定位问题 → 迭代修改代码”**的完整流程。
开发前端页面、做小游戏、图形化应用、调试后端脚本,都能边生成、边观测、边优化,视觉编程、界面复刻能力很能打。
2. 百万超长上下文
100 万 token,相当于一次性读近 70 万字的书、整套项目源码、几百页财报、多轮对话历史。配合优化后的注意力架构,超长文本不降精度、不卡顿——企业知识库检索、法律文书分析、金融研报整合、大型代码库通读这些专业场景都能扛。
3. 思考强度按需调节
调用时可根据任务复杂度调节推理深度:日常问答走轻量档,极速响应、成本最低;常规编程、文档总结走均衡档;复杂逻辑推理、深度代码调试、多步骤 Agent 任务拉满思考档,逼近旗舰水准。灵活控成本,不浪费一分算力。
四、性能实测:全面超越前代,编程对标 Claude Opus 4.8
智谱官方与第三方 Artificial Analysis 的多组基准,表现很亮眼:
- 综合能力:全面超越 GLM-5.2,AA 综合智能指数 57 分,与 Claude Opus 4.8 处于同一梯队
- 编程代码:DeepSWE v1.1 得分 63.4(GLM-5.2 仅 46.2,提升超 37%);TerminalBench 2.1 得分 84.3,代码终端执行、软件工程基准表现顶尖
- Agent 能力:Toolathlon Verified 工具调用 78.4 分,领先同类 8 分以上;AutomationBench 自动化基准 48.8(GLM-5.2 只有 26.2)
- 通用场景:联动搜索、文件读写、数据分析工具,做 Office 办公自动化、金融深度研究、专业文档处理,直接输出 PPTX、PDF、DOCX、XLSX 等格式文件
横向对比 DeepSeek-V4-Flash,在 TerminalBench、DeepSWE、Agent 基准等多个硬核维度上也有优势。
五、价格炸裂:官方定价 1/10,还限时 5 折
对开发者和企业来说,最香的还是定价。官方(Z.AI)现价:
| 计费项 | 单价(每百万 tokens) |
|---|---|
| 输入 tokens | $0.075 |
| 输出 tokens | $0.25 |
- 对比前代 GLM-5.3 的 $1.4 / $4.4,约为 1/10(官方口径,现促销期折算约 1/18)
- 限时 5 折促销中,截至 2026-09-09;还有 Coding Plan 套餐、非高峰时段半价
- 对比国际旗舰模型,成本差出一个数量级
用平民级 API 费用,享受接近国际旗舰的能力——AI 开发、Agent 落地、长文本处理的商业化成本直接被打下来。
六、本地部署友好,多框架已适配
权重已上架 Hugging Face 与魔搭(ModelScope),MIT 协议允许商用、二次修改,生态适配极快:
- 推理框架:SGLang、vLLM、Transformers、llama.cpp 等均已支持
- Ollama 一键跑:已上架,
ollama pull glm-5.3-flash即可本地运行 - 量化版本完善:1-bit 极致量化版仅需约 102GB 显存/内存;INT4、FP8 适配不同梯度硬件,个人工作站、小型服务器都能部署
- 并行能力:支持张量并行、专家并行,企业集群可搭高并发推理服务
本地部署实操(新手首选 Ollama):
# 1. 安装 Ollama 后,拉取模型
ollama pull glm-5.3-flash

# 2. 启动对话(支持图文输入)
ollama run glm-5.3-flash硬件参考:轻度测试 64G 内存 + 中端显卡走 INT4 量化即可;企业级高并发用多卡集群开专家并行。
七、总结:国产大模型从“堆参数”走向“抠效率”
GLM-5.3-Flash 的发布,标志着国产大模型在性能、成本、开放度三个维度完成了一次跨越:
- 320B 大总参打底,18B 稀疏激活控成本
- 百万上下文 + 原生多模态拓宽边界
- MIT 开源放开生态限制
- API 价格下探到普惠级别
国产大模型不再一味堆参数、拼算力,而是走向架构优化、效率优先的路线——GLM-5.3-Flash 就是这一趋势的标志性产品。个人开发者做项目、程序员调试代码、AI 爱好者本地玩模型、企业搭 Agent 处理海量文档,它都是当下性价比极高的选择。
想体验的,搜 GLM-5.3-Flash:魔搭 modelscope.cn、GitHub(github.com/zai-org/GLM-5)、Ollama 都拿到了,README 里部署教程齐全。
互动话题:你用过智谱的 GLM 系列吗?打算拿它做什么?欢迎评论区聊聊。
参考资料: 智谱官方 ModelScope 模型卡(ZhipuAI/GLM-5.3-Flash);官方 GitHub 仓库 github.com/zai-org/GLM-5;Z.AI 官方文档(docs.z.ai,含定价页);Ollama 官方模型库
价格与促销信息截至 2026-08-27(促销截止 2026-09-09),模型能力与定价可能迭代,请以官方最新文档为准。