面试官爱问:LangChain 和 LangGraph 到底什么关系?90% 的人第一句就答错
在大模型应用工程化落地中,LangChain 与 LangGraph 是开发者最容易混淆的两大核心框架。行业内普遍存在认知误区:有人认为 LangGraph 是 LangChain 的迭代替代品、La…
📑 本页目录
- 一、核心定位与底层架构:彻底厘清层级关系
- 1. LangChain:LLM 应用模块化组件库
- 2. LangGraph:有状态 Agent 工作流编排引擎
- 核心关系总结
- 二、核心机制深度拆解:看懂本质差异
- 1. 流程编排机制差异
- 2. 状态管理机制差异(生产级核心差距)
- 3. 可观测性与容错能力差异
- 三、精准适用场景:原型 VS 生产,一键选型
- 1. LangChain 专属适用场景(优先选用)
- 2. LangGraph 专属适用场景(必须选用)
- 四、实战代码对比:直观感受能力差距
- 1. LangChain LCEL 线性 RAG(最简实现)
- 2. LangGraph 迭代式智能问答(带循环 + 状态)
- 五、全方位维度对比表(生产级选型参考)
- 六、行业避坑指南:90% 开发者的选型误区
- 七、最终结论与生产级最佳实践
面试官爱问:LangChain 和 LangGraph 到底什么关系?90% 的人第一句就答错
别急着回答。先把“LangGraph 是 LangChain 的替代品”这句话咽回去——这是面试官最爱挖的坑。
在大模型应用工程化落地中,LangChain 与 LangGraph 是开发者最容易混淆的两大核心框架。行业内普遍存在认知误区:有人认为 LangGraph 是 LangChain 的迭代替代品、LangChain 已经淘汰,也有人盲目混用两者导致项目架构臃肿、状态失控、流程不可追溯。
事实上,二者并非迭代替代关系,而是生态分层、能力互补的协作架构,定位、底层抽象、运行机制、适用场景完全不同。本文从底层架构、核心机制、技术差异、落地场景、代码实操、生产避坑、最佳实践七个维度,系统拆解两大框架,彻底解决技术选型难题。
一、核心定位与底层架构:彻底厘清层级关系
LangChain 与 LangGraph 均由 LangChain AI 团队开发,同属一套技术生态,但核心职责完全拆分,是**「工具组件库」与「工作流编排引擎」**的层级关系,而非竞品。
1. LangChain:LLM 应用模块化组件库
LangChain 的核心定位是大模型应用基础工具箱,聚焦无状态、线性、快速组合,提供 LLM 应用开发的全量基础组件与链式编排能力。
其底层核心抽象为 Runnable(可运行单元),所有组件统一实现 Runnable 接口,支持通过 LCEL(LangChain 表达式语言) 的管道符 | 快速拼接,实现组件的标准化串联。
核心能力矩阵:
- 基础能力:模型调用、提示词模板、输出解析、文档加载、文本分割、向量检索
- 扩展能力:600+ 生态集成(LLM、向量库、第三方工具、数据库)、简易记忆管理、单链工具调用
- 编排能力:基于 DAG(有向无环图)的线性/简单分支流水线,不支持原生循环
- 状态能力:弱状态,仅支持单次会话临时记忆,无持久化、无状态回溯
简单概括:LangChain 负责「造零件、拼简单流水线」,是所有 LLM 应用的基础依赖,主打快速开发、低学习成本、高兼容性。
2. LangGraph:有状态 Agent 工作流编排引擎
LangGraph 是专门面向复杂 Agent 的状态机编排框架,是 LangChain 生态的上层运行时引擎,用于弥补 LCEL 无循环、无状态、不可控流程的短板。
其底层核心抽象为 StateGraph(状态图),将所有业务流程抽象为「节点(Node,执行逻辑)+ 边(Edge,流转规则)」,以全局共享状态(State) 为核心驱动流程运转。
核心能力矩阵:
- 核心特性:原生循环迭代、任意条件分支、全局状态管理、节点级流程控制
- 生产能力:内置 Checkpoint 持久化、任务断点续跑、人工介入(Human-in-the-loop)、节点级流式监控
- 高级能力:子图嵌套、多 Agent 消息通信、流程回溯、异常重试、可视化拓扑
- 兼容能力:完全兼容 LangChain 所有组件,可直接复用模型、工具、检索器
简单概括:LangGraph 负责「控流程、管状态、搭复杂智能体」,主打复杂逻辑编排、生产级稳定性、流程可控可追溯。
核心关系总结
- 非替代:LangGraph 不会取代 LangChain,底层依然依赖 LangChain 核心组件;
- 非并列:LangChain 是基础层,LangGraph 是编排层,上层工作流嵌套下层组件;
- 可独立:LangGraph 支持脱离 LangChain 独立运行,仅需自定义节点逻辑。
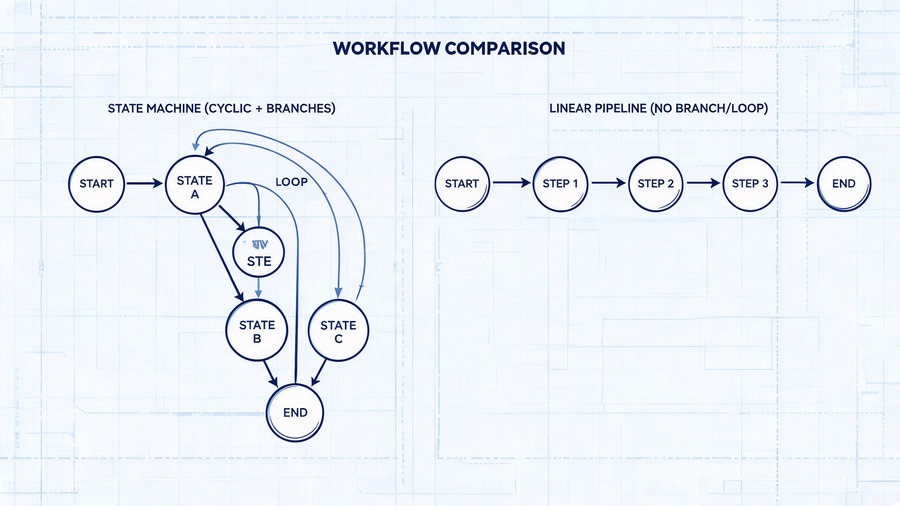
二、核心机制深度拆解:看懂本质差异
1. 流程编排机制差异
LangChain(LCEL):无状态线性串联
LCEL 的设计初衷是简化简单流水线的代码编写,所有流程遵循「单向流转、一次执行、无回溯」原则。仅支持简单的并行、分支能力,无法实现闭环迭代逻辑,复杂循环需要手动嵌套递归,代码冗余且不可控、无容错能力。
典型执行链路:输入 → 组件1 → 组件2 → 组件3 → 输出
核心缺陷:执行结束即销毁上下文,无法根据中间结果动态调整后续流程。
LangGraph(StateGraph):有状态动态流转
LangGraph 基于有限状态机(FSM) 设计,所有节点读写全局统一 State 对象,流程流转完全由「状态数据 + 自定义条件」驱动。支持三种核心流转模式:顺序执行、条件分支、循环迭代,天然适配 Agent 的「思考-行动-观察-再思考」迭代范式。
典型执行链路:初始化状态 → 节点执行更新状态 → 条件判断流转 → 循环迭代 / 终止输出
2. 状态管理机制差异(生产级核心差距)
状态管理是两者最本质的区别,也是生产环境选型的核心依据。
LangChain:弱临时状态
- 仅提供 ConversationBufferMemory 等简易记忆组件,状态存储在内存中;
- 会话结束、服务重启、任务报错即丢失状态;
- 无状态快照、无回溯、无断点续跑能力;
- 多轮复杂对话、长流程任务极易出现上下文错乱、状态丢失。
LangGraph:强持久化状态
- 内置 Checkpointer 检查点机制,支持将每一步节点执行后的状态持久化到 SQLite、PostgreSQL、Redis 等存储(官方提供 langgraph-checkpoint-sqlite / postgres / redis 三件套);
- 支持任务中断恢复:进程崩溃、服务重启后,可从最近检查点继续执行,无需从头重试;
- 支持人工介入暂停:关键节点可触发 interrupt 中断,等待人工确认、修改参数后继续流转;
- 支持流程回溯重试:可回退任意历史节点,重新执行分支逻辑,大幅降低复杂任务失败成本。
3. 可观测性与容错能力差异
- LangChain:仅支持全局链路日志,复杂多步骤流程无法精准定位报错节点,无原生容错、重试机制,需手动封装;
- LangGraph:节点级粒度监控,支持流式输出每一个节点的输入输出,原生可视化流程图,精准定位异常;同时支持自定义异常捕获、节点重试、分支降级,适配生产级高可用要求。
三、精准适用场景:原型 VS 生产,一键选型
1. LangChain 专属适用场景(优先选用)
所有逻辑固定、线性执行、无循环、无复杂状态依赖的 LLM 应用,首选 LangChain + LCEL,最大化提升开发效率、降低维护成本。
场景 1:标准线性 RAG 流水线
通用文档问答、知识库检索、文本摘要、内容改写、FAQ 问答,固定链路:问题 → 检索文档 → 拼接提示词 → LLM 生成 → 返回结果。几行 LCEL 代码即可实现稳定落地,无需引入重型图编排框架。
场景 2:快速 MVP 原型验证
业务初期需求不确定、仅需验证可行性的轻量化场景,LangChain 丰富的生态集成可快速搭建 Demo,大幅缩短试错周期。
场景 3:无状态单次工具调用
简单工具组合:LLM 翻译、文本分类、关键词提取、单次数据库查询、简单计算器调用,无多轮迭代、无需记忆复杂上下文。
场景 4:标准化固定对话机器人
简单客服问答、单轮咨询机器人,对话独立无联动,仅需基础记忆存储,无动态流程决策。
选型核心准则:无循环、无分支决策、无需持久化状态、短流程单次执行。
2. LangGraph 专属适用场景(必须选用)
所有动态决策、循环迭代、多步骤依赖、需要高可用的 Agent 类应用,LangChain 无法优雅实现,必须使用 LangGraph。
场景 1:迭代式自主 Agent(核心场景)
具备自主思考、工具迭代的智能体,例如:代码生成与调试 Agent、学术调研 Agent、数据分析 Agent、问题拆解求解 Agent。典型迭代逻辑:问题分析 → 工具调用 → 结果校验 → 不满足则迭代重试 → 输出最终结果。
场景 2:人工介入的关键业务流程
金融审核、工单处理、机票预订、权限审批、付费操作等敏感场景,需要机器自动执行 + 人工确认兜底,依赖 LangGraph 原生 interrupt 中断机制。
场景 3:长时运行、高容错业务任务
批量文档处理、自动化办公流程、多步骤数据清洗、长时间调研分析,任务耗时久、易中断,需要断点续跑、状态持久化保障稳定性。
场景 4:多 Agent 协作系统
规划 Agent、执行 Agent、校验 Agent、检索 Agent 多角色分工协作,需要子图嵌套、跨节点消息通信、状态同步,LangGraph 天然适配多智能体架构。
选型核心准则:有循环迭代、动态分支决策、需要状态持久化、长流程、多 Agent、生产级高可用。
四、实战代码对比:直观感受能力差距
1. LangChain LCEL 线性 RAG(最简实现)
适用于固定流程 RAG 问答,代码简洁高效:
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

# 初始化模型、提示词、解析器
llm = ChatOpenAI(model="gpt-3.5-turbo")
prompt = ChatPromptTemplate.from_template(
    "基于上下文回答问题:\n上下文:{context}\n问题:{question}"
)
parser = StrOutputParser()

# LCEL 线性链式编排,单向无循环
rag_chain = prompt | llm | parser

# 单次无状态调用
res = rag_chain.invoke({
    "context": "LangChain 适用于线性大模型应用",
    "question": "LangChain 的适用场景是什么?",
})
print(res)
短板:无法根据回答结果判断是否需要补充检索、无法迭代优化答案、无状态留存。
2. LangGraph 迭代式智能问答(带循环 + 状态)
实现「回答校验-不足则重新检索-迭代优化」的闭环 Agent 逻辑:
from langgraph.graph import StateGraph, END
from typing import TypedDict

# 1. 定义全局状态
class AgentState(TypedDict):
    question: str
    context: str
    answer: str
    retry_times: int

# 2. 定义节点逻辑
def retrieve_node(state: AgentState):
    # 模拟检索逻辑
    return {
        "context": "LangChain 线性场景,LangGraph 复杂 Agent 场景",
        "retry_times": state["retry_times"] + 1,
    }

def generate_node(state: AgentState):
    # 模拟生成答案
    return {"answer": f"基于上下文回答:{state['context']}"}

# 3. 定义条件流转:答案不足且次数 < 3 则继续检索
def condition_edge(state: AgentState):
    if len(state["answer"]) < 20 and state["retry_times"] < 3:
        return "retrieve"
    return END

# 4. 构建状态图
workflow = StateGraph(AgentState)
workflow.add_node("retrieve", retrieve_node)
workflow.add_node("generate", generate_node)

# 配置流转规则
workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "generate")
workflow.add_conditional_edges("generate", condition_edge)

# 编译运行
app = workflow.compile()
res = app.invoke({
    "question": "两者适用场景?",
    "context": "",
    "answer": "",
    "retry_times": 0,
})
print(res["answer"])
优势:原生支持循环迭代、状态累计、动态流程决策,可扩展持久化、人工介入、异常重试。
五、全方位维度对比表(生产级选型参考)
| 对比维度 | LangChain(LCEL) | LangGraph |
|---|---|---|
| 核心抽象 | Runnable Chain(链式单元) | StateGraph(状态有向图) |
| 流程结构 | 线性 DAG,仅支持简单分支 | 任意有向图,原生支持循环/嵌套 |
| 状态管理 | 内存临时状态,无持久化 | 全局状态对象,原生 Checkpoint 持久化 |
| 迭代能力 | 无原生循环,递归实现臃肿不稳定 | 原生循环迭代,适配 Agent 自迭代逻辑 |
| 人工介入 | 无原生支持,需手动封装 | 原生 Interrupt 暂停,无缝人机协同 |
| 容错恢复 | 无断点续跑,报错从头执行 | 支持状态回溯、断点续跑、节点重试 |
| 可观测性 | 全局链路日志,粒度粗糙 | 节点级流式监控、流程图可视化 |
| 多 Agent 支持 | 不适配,架构臃肿 | 原生子图、多角色消息通信 |
| 学习成本 | 低,上手快,适合新手 | 中等,需理解状态机、图编排思想 |
| 适用阶段 | 原型开发、轻量化 Demo、简单业务 | 生产落地、复杂 Agent、高可用长流程 |
| 性能开销 | 极低,轻量高效 | 略高,状态存储带来少量开销 |
六、行业避坑指南:90% 开发者的选型误区
误区 1:盲目认为 LangChain 过时淘汰
真相:LangGraph 无法脱离 LangChain 生态独立落地绝大多数场景。LangChain 是基础基建,只要做 LLM 应用开发就必须掌握,不存在过时一说。
误区 2:所有场景都用 LangGraph「过度设计」
真相:简单 RAG、单轮问答等线性场景,用 LangGraph 会增加代码复杂度、提升运维成本、造成性能冗余,属于典型的杀鸡用牛刀。
误区 3:复杂 Agent 用纯 LangChain 硬写
真相:用 LCEL 递归实现循环、分支逻辑,会导致代码耦合严重、状态混乱、无法排查报错,完全不具备生产可用性。
误区 4:两者功能重叠,二选一即可
真相:标准生产范式是 LangChain 做组件调用、LangGraph 做流程编排,二者组合才是工业级最优架构。
七、最终结论与生产级最佳实践
一句话核心总结
LangChain 是「积木组件库」,负责快速搭建基础能力;LangGraph 是「流程指挥台」,负责管控复杂动态逻辑,二者互补而非对立。
分层选型最佳实践
- 轻量化简单业务:纯 LangChain + LCEL,快速落地、极简维护;
- 中等复杂度多轮对话:LangChain 组件 + 简易 LangGraph 状态编排;
- 生产级复杂 Agent / 多智能体系统:全量 LangGraph 架构,复用 LangChain 生态组件,开启持久化、人工介入、节点监控;
- 迭代式项目落地:初期用 LangChain 快速做 MVP 验证,业务复杂化后平滑迁移至 LangGraph 流程编排。
终极落地准则
简单追求效率选 LangChain,复杂追求稳定选 LangGraph,生产落地两者结合。
延伸学习资源(按优先级排列)
- LangChain 1.0 官方 LCEL 核心文档
- LangGraph 状态机与 Checkpoint 持久化原理
- LangChain 生态全套工程化体系(LangChain + LangGraph + LangSmith 可观测链路)
- 生产级 Multi-Agent 多智能体架构实战