腾讯突然开源维纳拉:你的文档,马上要开口说话了!
WeKnora(社区常称“维纳拉“)是腾讯于 2025 年 8 月正式开源的基于大语言模型的文档理解与语义检索框架,源自微信对话开放平台的核心技术,专为结构复杂、内容异构的文档场景打造,提供从多模态解…
📑 本页目录
腾讯突然开源“维纳拉”:你的文档,马上要开口说话了!
WeKnora(维纳拉)深度拆解 + 保姆级部署避坑指南,一文讲透
腾讯开源 WeKnora(维纳拉),基于大模型的文档理解与语义检索框架,支持多模态解析、RAG 问答、ReAct Agent、知识图谱、跨会话记忆、技能沙箱,可私有化部署。本文从核心能力、技术架构到 Docker/Helm/Ollama 部署与避坑,一次讲清。
一、项目速览
WeKnora(社区常称“维纳拉”)是腾讯于 2025 年 8 月正式开源的基于大语言模型的文档理解与语义检索框架,源自微信对话开放平台的核心技术,专为结构复杂、内容异构的文档场景打造,提供从多模态解析到智能问答的端到端能力。
- 官网地址:https://weknora.weixin.qq.com
- GitHub 仓库:https://github.com/Tencent/WeKnora(当前 2.7 万+ ⭐,持续高速迭代)
一句话概括:它能让你的文档“活起来”,不再是静态文件,而是可以对话的“智能专家”。企业知识管理、科研文献分析、法律合规审查……它都能大显身手。
项目采用 MIT 开源协议,本文整理时对应版本为 v0.8.0。它已从最初的“知识库问答”进化到“带记忆、能执行、可扩展的 Agent 知识底座”。
二、它到底解决什么问题?
传统文档检索的三大痛点,WeKnora 都给出了针对性方案:
- PDF/扫描件/表格难以结构化 → 支持 PDF 版式分析、扫描件 OCR、Office 转换、网页抓取与图片描述,可选 OpenDataLoader/Docling 混合解析
- 单一向量检索召回不稳 → 向量 + 关键词(BM25)混合检索,RRF 融合,Rerank 重排,可选知识图谱(GraphRAG)与 Wiki 导航
- 数据安全与私有化 → 全栈可私有部署,敏感凭证以 AES-256 落盘加密,多租户隔离 + RBAC 角色鉴权
三、核心能力全景
1、RAG 问答与检索
系统采用检索增强生成(RAG)机制:先解析文档并建立索引,再根据问题检索相关片段,由大模型生成回答,回答中附引用可追溯原文。支持快速模式(毫秒级响应)和深度模式(Agent 多步推理处理复杂问题)两种对话方式。
2、ReAct Agent 智能体
内置基于 ReAct 模式的多步推理智能体,可调用本地知识库、MCP 工具、Web 搜索(SearXNG 等)、甚至对 CSV/Excel 执行 SQL 数据分析。
举个例子:下达“分析某行业政策并生成合规报告”的指令后,Agent 会自动拆解任务、检索信息、整合分析,全程无需人工干预。
3、Wiki 模式与知识图谱
智能体可将原始文档蒸馏为自我维护的互联 Markdown 知识库,配有交互式知识图谱,支持手动编辑、修订历史和一键回滚。
知识图谱功能基于 Neo4j,帮助理解文档中不同段落之间的语义关联,提升检索结果的相关性和广度。
4、v0.8.0 新增重磅能力
- 跨会话长期记忆:按用户维度记住画像、偏好、事实、待办、兴趣五类信息,后台自动提取但默认进入“观察中”状态,需你确认后才正式生效
- 技能沙箱:Agent 可在 Docker/E2B/Cube 沙箱中安全执行代码和任务,会话持久化,碰不到宿主机
- Skills 技能市场:从 ClawHub/SkillHub/git/zip 安装技能,支持按沙箱快照、实时进度、文件浏览编辑
5、多源接入与多端覆盖
支持飞书、Notion、语雀、GitLab、腾讯 IMA、钉钉文档、RSS 等平台的自动同步,覆盖 PDF、Word、图片、Excel、XMind 等 10+ 文档格式。
对外可通过企业微信、飞书、Slack、Telegram 等 IM 渠道直接提供问答服务,也有 Chrome 浏览器扩展和网站嵌入组件。
6、模型兼容性
兼容 20+ 主流 LLM 提供商:OpenAI、DeepSeek、通义千问、智谱、混元、Gemini、MiniMax、NVIDIA、LiteLLM、Ollama 等,LLM/Embedding/Rerank/VLM/ASR 分类管理,可灵活切换。
四、技术架构
系统组成
WeKnora 采用“主服务 + 前端 + 文档解析微服务”的三进程核心架构:
| 组件 | 技术栈 | 职责 |
|---|---|---|
| 后端主服务 | Go | 业务逻辑、API、Agent 调度 |
| 前端 | Vue 3 | Web 交互界面 |
| 文档解析服务 | Python(docreader) | 文档解析、OCR、格式转换 |
| 数据库 | ParadeDB(PostgreSQL 17) | 业务数据 + 全文检索 |
| 消息队列 | Redis + Asynq | 异步任务调度 |
| 向量库(可选) | Qdrant/Milvus/Weaviate 等 | 向量检索 |
| 知识图谱(可选) | Neo4j | GraphRAG 实体关系 |
RAG 流水线设计
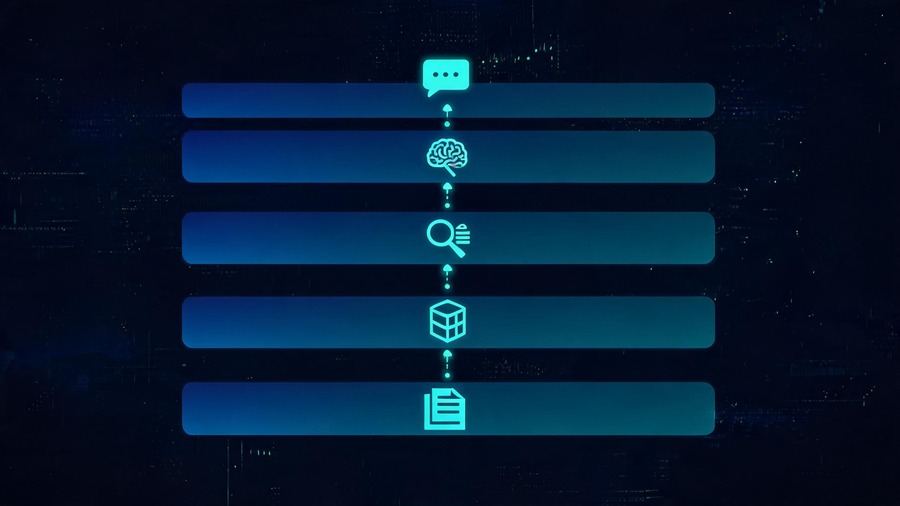
整个问答链路是一条事件驱动的插件管线(Event-Driven Plugin Pipeline),每个阶段是一个实现 Plugin 接口的插件,从 HTTP 入口到流式回答落盘全链路可追踪。
架构分为五层:文档处理层 → 知识建模层 → 检索引擎层 → 推理生成层 → 交互展示层。
五、部署指南
WeKnora 支持 Docker Compose、Kubernetes Helm、Lite 单二进制、桌面应用四种部署形态。
| 形态 | 入口 | 数据库 | 适用场景 |
|---|---|---|---|
| Docker Compose(标准) | docker-compose.yml | ParadeDB(PostgreSQL) | 生产/团队自托管(推荐) |
| Docker Compose(开发) | docker-compose.dev.yml | 同上 | 本地开发 |
| Helm | helm/ | ParadeDB(chart 内置) | Kubernetes >= 1.25 |
| Lite 单二进制 | make build-lite | SQLite(FTS5+sqlite-vec) | 个人/离线/低资源 |
| 桌面应用(未正式发布) | cmd/desktop(Wails v2) | SQLite | 桌面单机使用 |
以下重点介绍最常用的 Docker Compose 标准部署。
环境要求
- Docker 20.10+ 与 Docker Compose v2
- 建议 4 核 CPU / 8GB 内存起步(docreader 含 LibreOffice、Playwright,较吃内存)
- 磁盘按知识库规模预留(Postgres 卷 + /data/files 文件卷)
- 模型服务:本地推理需 Ollama,或任意 OpenAI 兼容 API(DeepSeek、通义、智谱等)
部署步骤
第 1 步:克隆仓库
git clone https://github.com/Tencent/WeKnora.git
cd WeKnora
第 2 步:配置环境变量
cp .env.example .env
# 编辑 .env 填入对应配置信息
.env.example 文件中有详细注释,可根据实际情况修改。重点关注以下配置项:
- 数据库端口:默认 5432(如被占用需修改 DB_PORT)
- 前端端口:默认 80(如被占用需修改 FRONTEND_PORT)
- Ollama 地址:默认 http://host.docker.internal:11434,注意 Docker 容器内访问宿主机需用 host.docker.internal 而非 localhost
- 模型配置:填入 LLM、Embedding、Rerank 等模型信息
第 3 步:启动服务
# 方式一:一键启动(含 Ollama 与后端容器)
./scripts/start_all.sh
# 或
make start-all

# 方式二:仅启动 WeKnora 服务(已有 Ollama 时)
docker compose up -d
第 4 步:访问服务
启动成功后:
- Web UI:http://localhost
- 后端 API:http://localhost:8080
- 链路追踪(Jaeger):http://localhost:16686
第 5 步:停止服务
./scripts/start_all.sh --stop
# 或
make stop-all
可选组件的开启
通过 Docker Compose profiles 控制可选子系统:
| Profile | 组件 | 用途 |
|---|---|---|
| minio | S3 兼容对象存储 | 文件存储 |
| qdrant / milvus / weaviate | 替代向量检索引擎 | 向量检索 |
| neo4j | 知识图谱存储 | GraphRAG |
| langfuse | 可观测性平台 | 全链路追踪 |
| searxng | Web 搜索提供者 | Agent 联网搜索 |
启动时可指定 profile,例如:
docker compose --profile neo4j --profile langfuse up -d使用 Ollama 的配置要点
推荐使用 bge-m3 作为 Embedding 模型——北京智源 BAAI 开源的向量模型,社区部署 WeKnora 的主流选择,性能稳、兼容性好。先拉取模型:
ollama pull bge-m3然后在 WeKnora 的 Web 界面中配置知识库:
- 左侧点击「知识库」→「新建知识库」
- 点击「设置」进入配置界面
- 配置 LLM 模型(本地 Ollama 或远程 API 如 DeepSeek)
- 配置 Embedding 模型(选 bge-m3)
- Rerank 模型本地测试可关闭
Helm/Kubernetes 部署
WeKnora 提供完整的 Helm Chart,可在 K8s 集群一键部署全套组件。
默认资源配置:app 容器 1 CPU/1Gi 内存 limit,100m CPU/256Mi 内存 request。Helm 部署支持 Neo4j 模板以启用 GraphRAG 功能。
六、部署避坑指南
根据社区实践,以下问题值得特别注意:
- Docker 容器内访问宿主机服务:如果 Ollama 或其他模型服务跑在宿主机上,Base URL 需用 host.docker.internal 替换 localhost,且服务必须监听 0.0.0.0 而非 127.0.0.1。
- 上传文件权限报错:出现 mkdir permission denied 时,检查 .env 中文件目录环境变量,改为有写入权限的目录。
- 数据持久化:务必使用命名 volume 而非匿名 volume,否则 docker compose down 后数据全部丢失。同时注意修改 POSTGRES_PASSWORD 后需重建容器才生效,以及容器时区问题。
- 模型配置不完整导致无法检索:如果出现“文档能解析但搜不出来”的情况,通常是 Embedding 模型和对话模型未正确设置,需检查 .env 中的模型信息是否配置完整。
- asynq worker 假死:bge-m3 和 minicpm-v 并发时可能出现 VLM 超时 → worker 假死 → pending 堆积,建议关注资源配额和并发限制。
- 端口冲突:默认前端 80 端口和数据库 5432 端口容易冲突,在 .env 中修改 FRONTEND_PORT 和 DB_PORT 为未使用端口即可。
七、适用场景
| 场景 | 具体应用 | 核心价值 |
|---|---|---|
| 企业知识管理 | 内部文档检索、规章制度问答、操作手册查询 | 知识探索效率提升、培训成本降低 |
| 科研文献分析 | 论文检索、研究报告分析、学术资料整理 | 文献调研加速 |
| 产品技术支持 | 产品手册问答、技术文档检索、故障排查 | 客户支持质量提升 |
| 法律合规审查 | 合同条款检索、法规政策查询、案例分析 | 合规效率提升 |
| 医疗知识辅助 | 医学文献检索、诊疗指南查询、病例分析 | 知识获取加速 |
有企业用户反馈部署 WeKnora 后,技术手册查询时间从半小时级缩短到分钟级(社区案例口径,仅供参考)。
八、写在最后
WeKnora 是腾讯在企业级 AI 领域的重要开源成果。从 v0.1 到 v0.8,它已经从“能问答”进化到“能办事”——长记忆让协作连续,沙箱让 Agent 敢动手,Skills 让能力可沉淀。
目前项目仍在高速迭代中,社区活跃,官方也推出了“WeKnora 知识分享季”等运营活动。
对于公众号读者来说,无论你是想搭建私有知识库、研究 RAG 技术,还是寻找企业级文档智能方案,WeKnora 都值得深入了解和上手实践。
你的文档,该开口说话了。 点个“在看”,转发给正在被文档折磨的同事;关注我们,持续拆解腾讯开源项目。
📌 数据说明:文中项目信息均经 GitHub 核验(2026-09-19):Tencent/WeKnora 当前 2.7 万+⭐、MIT 协议、v0.8.0(2026-09-03 发布)、官网可达。部署步骤基于官方 README 与 .env.example 整理;bge-m3 为智源 BAAI 开源向量模型(非腾讯出品)。企业查询效率数据为社区案例口径,仅供参考。