本体论和知识图谱,到底什么关系?一篇从哲学讲到工程(收藏级长文)
在人工智能、大模型 RAG、语义搜索、智能问答、行业知识库落地的当下,本体论(Ontology)和知识图谱(Knowledge Graph)是绕不开的两大核心基石。
📑 本页目录
- 彻底搞懂本体论与知识图谱:从哲学溯源到工程落地
- 01 哲学溯源:从「存在之学」到 AI 工程蓝图
- 1.1 本体论(Ontology):源于哲学的先验规范
- 1.2 知识图谱(Knowledge Graph):源于工程的经验集合
- 1.3 核心哲学分野(贯穿全文的底层逻辑)
- 02 核心定义与通俗类比:一秒分清二者
- 2.1 核心维度对比表
- 2.2 四重极致通俗类比
- 03 行业实战示例:文学领域完整落地演示
- 3.1 本体论(Schema 层):定义规则
- 3.2 知识图谱(Data 层):填充实例
- 3.3 无本体约束的致命问题
- 04 七大核心维度深度差异(工程必看)
- 4.1 抽象层次不同
- 4.2 范围与粒度不同
- 4.3 技术表达不同
- 4.4 推理能力边界不同
- 4.5 世界观假设不同(核心底层差异)
- 4.6 演化方式不同
- 4.7 建设成本曲线不同
- 05 二者共生关系:双向约束、闭环演化
- 5.1 层级架构关系
- 5.2 标准工程落地流程
- 5.3 三种工程耦合模式(项目选型必看)
- 06 形式化内核:读懂描述逻辑与 OWL 体系
- 6.1 知识库核心结构
- 6.2 OWL 2 三大实用子集(生产必备)
- 07 知识图谱存储架构:RDF vs 属性图
- 7.1 RDF 三元组模型(语义标准)
- 7.2 属性图模型(工程主流)
- 7.3 关键差异底层原因
- 08 核心约束体系:OWL 推理 + SHACL 数据校验
- 8.1 OWL:负责逻辑推理
- 8.2 SHACL:负责数据校验(生产质量门禁)
- 8.3 约束违规三大工程策略
- 09 完整工程技术栈与落地方法
- 9.1 本体构建主流方法论
- 9.2 核心工具矩阵
- 9.3 全层级技术架构
- 9.4 最优落地策略:中间相遇法
- 10 前沿技术趋势:AI 大模型时代的新融合
- 10.1 神经符号融合
- 10.2 图神经网络 GNN
- 10.3 LLM + KG 深度融合(Graph RAG)
- 10.4 多模态知识图谱
- 10.5 时序知识图谱 + 动态本体
- 10.6 联邦知识图谱
- 11 九大常见误区深度澄清(避坑指南)
- 12 工程落地决策树(项目选型直接套用)
- 12.1 场景决策逻辑
- 12.2 分阶段投入标准
- 13 跨领域实战对照表(医学/金融/电商)
- 全文总结
彻底搞懂本体论与知识图谱:从哲学溯源到工程落地
在人工智能、大模型 RAG、语义搜索、智能问答、行业知识库落地的当下,本体论(Ontology)和知识图谱(Knowledge Graph)是绕不开的两大核心基石。
绝大多数初学者、工程从业者都会陷入同一个误区:把本体论和知识图谱混为一谈。
有人觉得二者是同一个东西,有人觉得知识图谱包含本体,也有人认为本体只是知识图谱的附属配置。
事实上,二者是**「规范与实例、蓝图与建筑、语法与语料、先验逻辑与后验数据」的层级关系,不是包含、不是并列,是强依赖、互补共生、双向演化**的 AI 知识体系双核心。
这篇文章从哲学溯源、核心定义、通俗类比、实战示例、核心差异、工程架构、约束机制、技术栈、避坑误区、落地决策、跨领域实战十余个维度,系统、完整地拆解本体论与知识图谱,所有内容经过工程化梳理,适合学习收藏、团队内训。
01 哲学溯源:从「存在之学」到 AI 工程蓝图
想从根源上读懂二者差异,必须追溯词源与底层哲学逻辑。所有技术差异,本质都是哲学底层范式的分歧。
1.1 本体论(Ontology):源于哲学的先验规范
Ontology 源自希腊语:ontos(存在)+ logos(学说),本义是研究存在本身的第一哲学。
从亚里士多德提出「第一哲学」,追问「什么是存在者之为存在者」,到 17 世纪学者正式定名 Ontologia,本体论千年以来的核心内核从未改变:不研究具体事物,只研究事物存在的规则、结构、本质逻辑。
1993 年,AI 先驱 Tom Gruber 将这一哲学概念引入计算机领域,给出经典定义:
本体论:概念化的显式规范说明
计算机领域的本体论,完美继承了哲学基因:
- 关注先验规则:世界/领域「应当」如何结构化
- 关注逻辑规范:概念、属性、关系、约束的底层范式
- 不依赖具体数据,是通用、稳定、抽象的顶层框架
1.2 知识图谱(Knowledge Graph):源于工程的经验集合
知识图谱是纯粹的互联网工程产物,2012 年由谷歌正式提出,核心目的是优化语义搜索、让机器读懂网页知识。
它的哲学内核是经验主义:
- 不预设领域规则,不定义「应当是什么」
- 只从海量真实数据中,归纳、抽取、记录「实际是什么」
- 承载海量事实、实体、关联,是具体、动态、可迭代的数据网络
1.3 核心哲学分野(贯穿全文的底层逻辑)
- 本体论:先验、规范、逻辑化、定义规则
- 知识图谱:后验、描述、经验化、承载实例
后续所有技术区别、工程落地差异、推理能力差异,全部源于这一分野。
02 核心定义与通俗类比:一秒分清二者
本体论与知识图谱,是 TBox 术语层与 ABox 实例层的上下层关系,这里用 4 组通俗类比,彻底吃透层级差异。
2.1 核心维度对比表
| 维度 | 本体论(Ontology) | 知识图谱(Knowledge Graph) |
|---|---|---|
| 核心本质 | 领域概念模型与逻辑规范 | 结构化、可推理的知识网络 |
| 存储内容 | 类、属性、关系、公理、约束 | 实体、属性值、实例三元组、关联链路 |
| 通俗类比 | 数据库 Schema、建筑蓝图、语法规则 | 数据库数据、建成建筑、真实语料 |
| 核心目的 | 统一领域认知,规范数据语义 | 存储海量知识,支撑查询、推理、应用 |
| 迭代特性 | 稳定、低频、自上而下 | 动态、高频、自下而上 |
2.2 四重极致通俗类比
类比 1:宪法 & 户籍档案
- 本体论 = 领域宪法:规定领域的基本制度、概念边界、关系规则,不针对任何个体,所有实例必须遵守,修改成本极高。
- 知识图谱 = 户籍档案:记录每一个具体个体的信息、关系、属性,日常新增、修改、注销,灵活迭代。
类比 2:语法 & 文章语料
- 本体论 = 汉语语法:规定什么是名词、动词,什么句式合法,杜绝语病。
- 知识图谱 = 海量文章:遵循语法规则书写的真实内容,内容千变万化,但必须符合语法规范。
类比 3:类定义 & 对象实例(面向对象编程)
- 本体论 = Class 类 + 接口契约:定义「人物」类有姓名、生卒年属性,定义「创作」关系仅能发生在人物与作品之间。
- 知识图谱 = new 出来的对象:曹雪芹(人物)→ 创作 → 红楼梦(作品)的具体实例。
类比 4:图书分类法 & 馆藏图书
- 本体论 = 中图法分类体系:规定文学、历史、科技的类目层级与定义。
- 知识图谱 = 图书馆所有藏书:每一本书的具体信息、归类、位置、关联。
03 行业实战示例:文学领域完整落地演示
以文学领域知识体系为例,直观区分「本体 Schema 层」和「图谱数据层」。
3.1 本体论(Schema 层):定义规则
本体负责定义领域所有合法的概念与约束,无任何具体实例:
- 核心类:人物、作品、体裁、朝代
- 核心属性:姓名、生卒年、成书年代、别名
- 核心关系:创作、属于体裁、生活于朝代、包含主要人物
- 刚性约束
- 「创作」关系:定义域 = 人物,值域 = 作品
- 每一部作品必须至少有一位创作者
- 体裁、朝代为独立概念,不可混淆
3.2 知识图谱(Data 层):填充实例
基于本体规则,生成海量真实三元组与实体网络:
- 核心实体:曹雪芹、红楼梦、清代、章回体小说、贾宝玉、林黛玉
- 核心三元组
- 曹雪芹 — 创作 → 红楼梦
- 红楼梦 — 属于体裁 → 章回体小说
- 曹雪芹 — 生活于 → 清代
- 红楼梦 — 成书年代 → 清代
- 红楼梦 — 主要人物 → 贾宝玉
- 红楼梦 — 主要人物 → 林黛玉
3.3 无本体约束的致命问题
如果没有本体 Schema 约束,直接从文本抽取数据,知识图谱会彻底沦为结构化噪声:
- 错误三元组:曹雪芹 — 创作 → 红烧肉(语义关系混淆)
- 类型错误:红楼梦 — 属于体裁 → 清代(混淆朝代与体裁)
- 逻辑错误:贾宝玉 — 创作 → 林黛玉(关系定义错乱)
核心结论:本体论是知识图谱的质量防线,从逻辑层面杜绝语义错误;知识图谱是本体论的价值载体,让抽象规则落地为可用知识。
04 七大核心维度深度差异(工程必看)
结合理论与落地场景,梳理二者最关键的 7 项核心区别,彻底告别认知模糊。
4.1 抽象层次不同
- 本体论(T-Box 术语层):定义「领域有什么、能有什么、不能有什么」,是概念的集合。
- 知识图谱(A-Box 断言层):描述「具体是什么、有什么关联」,是事实的集合。
4.2 范围与粒度不同
- 本体:通用、全局、稳定,覆盖整个领域的核心框架,数月甚至数年不变。
- 图谱:具体、局部、动态,实体、三元组每日增量更新、迭代修正。
4.3 技术表达不同
- 本体:基于 OWL、RDFS,核心能力是逻辑约束、语义推理、公理定义。
- 图谱:基于 RDF 三元组、属性图,核心能力是数据存储、图遍历、关联查询。
4.4 推理能力边界不同
| 能力 | 本体论 | 知识图谱 |
|---|---|---|
| 概念层级推理 | 极强,自动识别子类、层级继承 | 弱,需人工硬编码规则 |
| 属性传递推理 | 支持祖先、从属等传递推理 | 仅支持显式路径遍历 |
| 逻辑矛盾检测 | 自动识别逻辑冲突、数据悖论 | 无原生冲突检测能力 |
| 多跳关联发现 | 不擅长实例关联挖掘 | 天然支持图遍历多跳查询 |
| 相似度计算 | 无原生能力 | 支持图嵌入、GNN 相似度计算 |
4.5 世界观假设不同(核心底层差异)
本体 / OWL:开放世界假设(OWA)
未声明 ≠ 不存在,仅代表未知。
例:本体未录入曹雪芹死亡日期,系统不会判定「曹雪芹无死亡日期」,仅判定「数据未收录」,符合人类认知的不完备性。
图谱 / 数据库:封闭世界假设(CWA)
未记录 = 不成立、不存在。
例:图谱查询不到死亡日期,业务层面默认该事实不存在,适配工程决策的确定性需求。
4.6 演化方式不同
- 本体论:自上而下、低频迭代、谨慎变更。修改类、关系、约束,会影响全量图谱数据,属于架构级变更。
- 知识图谱:自下而上、高频迭代、敏捷更新。新增实体、三元组不影响整体架构,属于数据级变更。
4.7 建设成本曲线不同
- 本体:前期成本高,后期成本极低。需要领域专家建模,周期长,但建成后数据质量、推理能力可长期复用。
- 图谱:前期成本低,后期成本爆炸。可快速上线 MVP,但无本体约束时,数据冲突、冗余、错误会随规模指数级增长。
工程铁律: 无本体约束的知识图谱,百万级实体是成本拐点,后期清洗修复成本远超前期建模成本。
05 二者共生关系:双向约束、闭环演化
本体和图谱不是竞争、不是替代,是架构分层、双向赋能、闭环迭代的共生关系。
5.1 层级架构关系
本体论与知识图谱构成「TBox 术语层 + ABox 数据层」的上下双层架构:
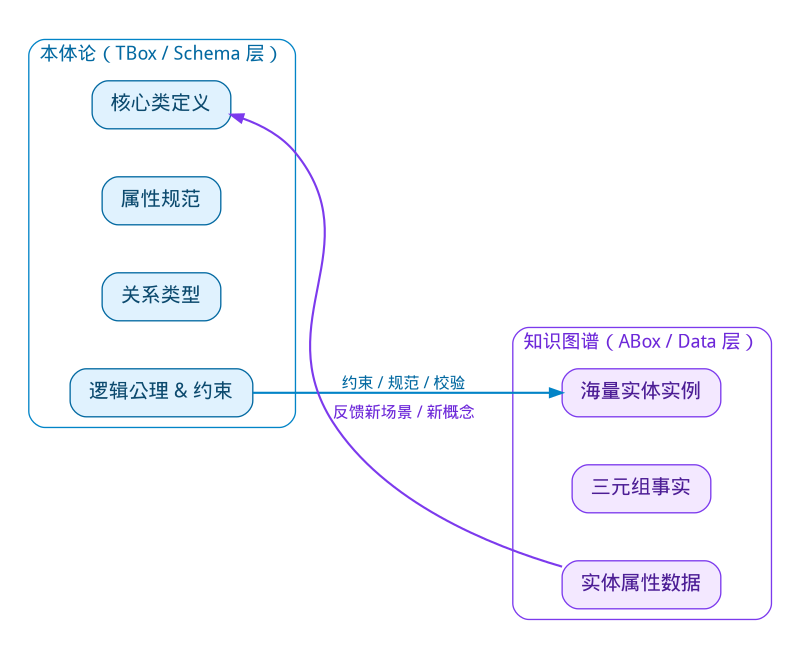
- 本体 → 图谱(约束、规范、校验): 本体向下约束数据结构的合法性,保证图谱质量
- 图谱 → 本体(反馈新场景、新概念): 图谱数据向上暴露新需求,反哺本体迭代
二者双向赋能、闭环演化,缺一不可。
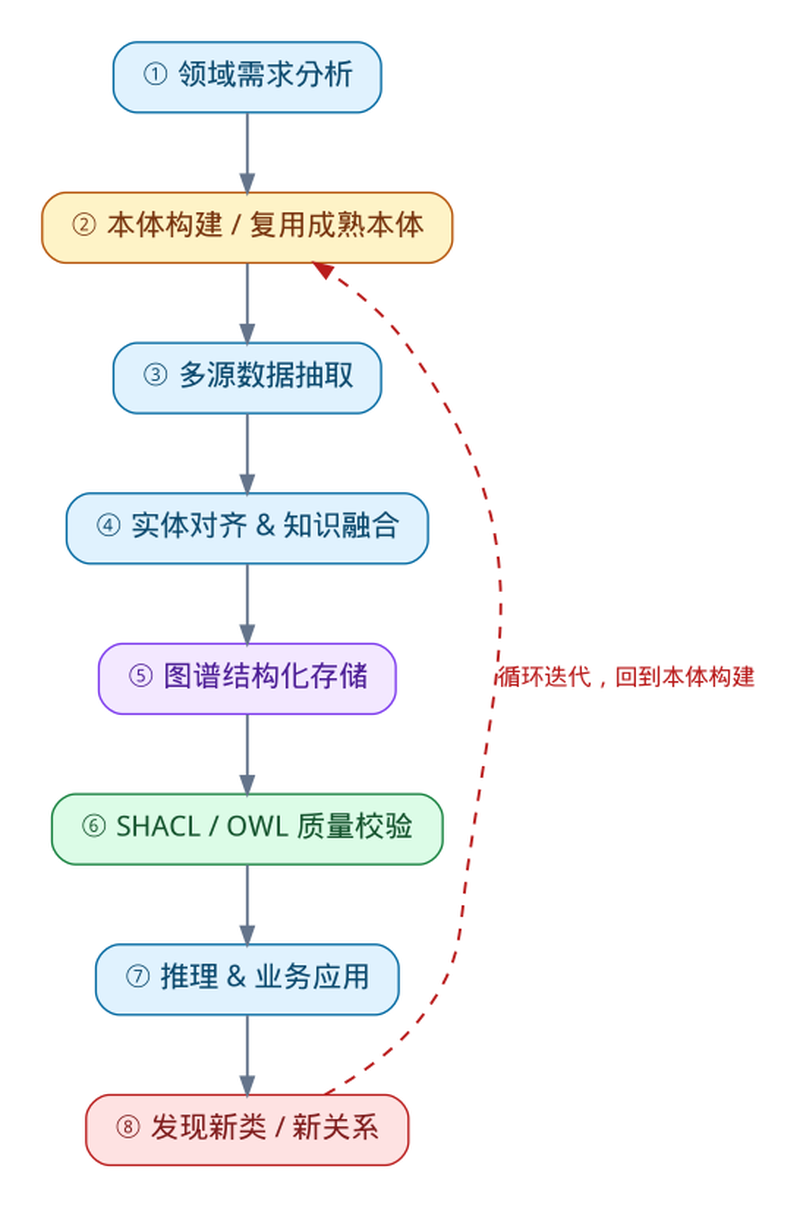
5.2 标准工程落地流程
完整流程:先建规则(本体)→ 填充数据(图谱)→ 业务验证 → 迭代优化本体。
5.3 三种工程耦合模式(项目选型必看)
模式 1:紧耦合(RDF + OWL 全栈)
数据与本体强绑定,推理机直接作用于数据集,语义一致性最强,适合政务、医疗、金融合规高精度场景,缺点是推理性能开销大。
模式 2:松耦合(Neo4j + 独立 OWL)
属性图存储数据,独立本体文件做语义校验,查询性能高、工程灵活,是互联网、企业级项目主流选型。
模式 3:轻量耦合(RDF + RDFS)
仅保留基础层级、值域约束,舍弃复杂 OWL 公理,简单高效、迭代快,适合初创项目、POC 验证。
06 形式化内核:读懂描述逻辑与 OWL 体系
本体论的核心是描述逻辑(DL),是机器可理解、可推理的形式化语言。
6.1 知识库核心结构
完整知识知识库:K = (T, A)
- T-Box(术语集):通用规则,定义类、层级、关系约束
- 概念包含:Person ⊑ Animal(人属于动物)
- 角色约束:创作关系仅人物可发起
- A-Box(断言集):具体事实,即知识图谱的所有实例
- 概念断言:曹雪芹是人物
- 关系断言:曹雪芹创作红楼梦
6.2 OWL 2 三大实用子集(生产必备)
为解决完整 OWL 推理复杂度高的问题,W3C 定义三类可工程化的 Profile:
- OWL EL:多项式复杂度,适配医疗、超大领域本体(SNOMED CT)
- OWL QL:查询优化专用,适配本体增强数据库查询场景
- OWL RL:规则引擎兼容,适配业务规则复杂的金融、风控场景
07 知识图谱存储架构:RDF vs 属性图
知识图谱主流两种存储模型,适配不同业务场景,无优劣之分,只有适配之别。
7.1 RDF 三元组模型(语义标准)
基于 W3C 国际标准,以「主语-谓语-宾语」三元组存储,天然适配本体推理、跨系统语义互通,配套查询语言 SPARQL。
核心优势:全局唯一 IRI 标识、原生支持 RDFS/OWL 推理、标准化可互通。适用场景:知识共享、开放域知识库、学术/政务知识体系。
7.2 属性图模型(工程主流)
以节点、边、自定义属性为核心(代表工具 Neo4j),是工程界最常用的存储方案,配套查询语言 Cypher。
核心优势:查询性能高、图遍历灵活、支持复杂属性存储。适用场景:推荐系统、风控链路、关联分析、业务图谱。
7.3 关键差异底层原因
- RDF 是逻辑命题,每一条三元组都是独立公理,天然可推理;
- 属性图是数据记录,标签仅为分类标记,无原生语义逻辑,需外挂本体约束。
08 核心约束体系:OWL 推理 + SHACL 数据校验
很多项目数据混乱的核心原因:混淆了 OWL 逻辑推理和 SHACL 数据校验。
8.1 OWL:负责逻辑推理
基于开放世界假设,挖掘隐性知识、推导新事实、识别逻辑悖论。
8.2 SHACL:负责数据校验(生产质量门禁)
W3C 官方约束标准,基于封闭世界假设,直接判定数据合法/违规,是企业图谱落地的核心质量工具。
支持的核心约束:基数约束、数据类型约束、值域约束、正则约束、封闭属性约束等。
8.3 约束违规三大工程策略
- 拒绝写入:高精密场景(金融、医疗),脏数据直接拦截
- 标记异常:开放域场景,容忍噪声,人工复核异常数据
- 自动修复:结构化数据场景,规则化修正格式、类型错误
09 完整工程技术栈与落地方法
9.1 本体构建主流方法论
- Ontology Development 101:通用标准方法论,适合新手落地
- NeOn 方法论:模块化、可复用、敏捷迭代,适合大型复杂领域
9.2 核心工具矩阵
- 本体建模:Protégé、WebProtégé、TopBraid Composer
- 知识存储:GraphDB、Virtuoso、Neo4j、JanusGraph
- 抽取融合:NLP 实体识别、关系抽取、共指消解、实体对齐
9.3 全层级技术架构
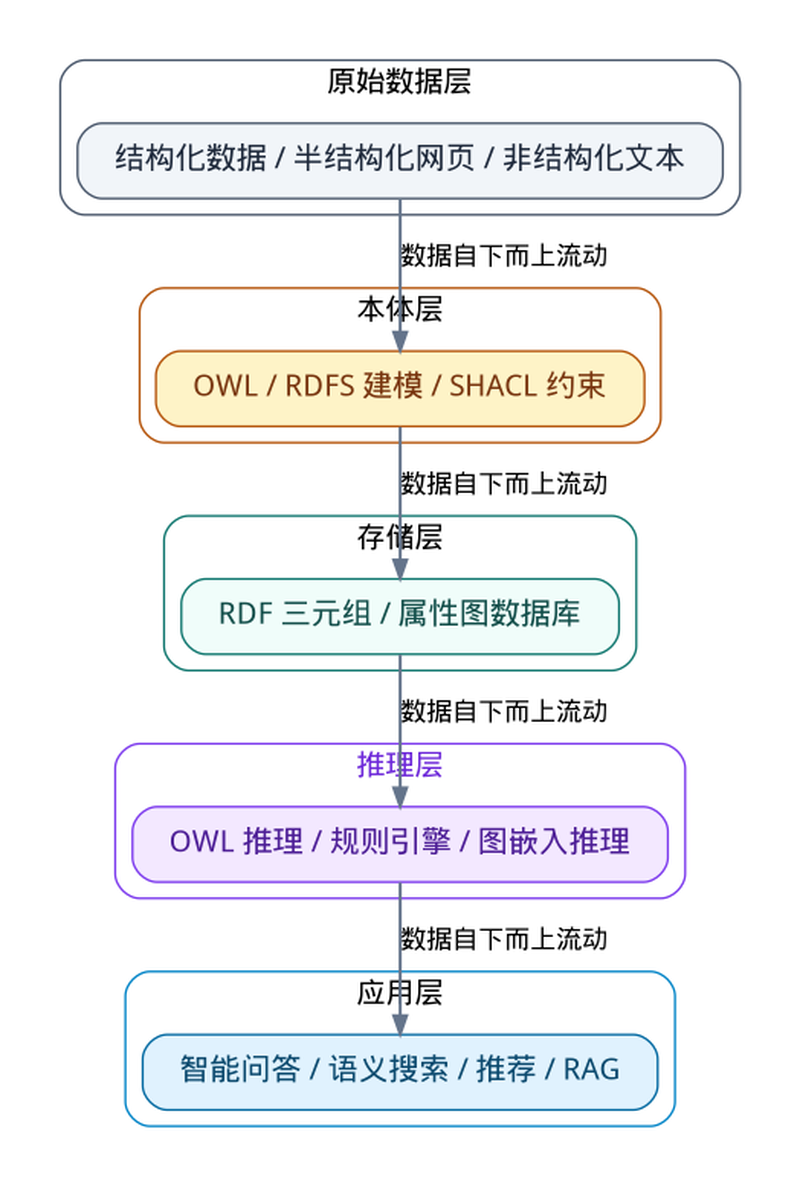
数据自下而上流动,逐层加工、推理、消费:原始数据 → 本体建模 → 图谱存储 → 推理引擎 → 上层应用。
9.4 最优落地策略:中间相遇法
摒弃「一次性建完美本体」和「纯数据无规范」两个极端:
- 先搭建最小可行本体(MVO),快速启动数据抽取
- 批量沉淀图谱数据,暴露领域新概念、新关系
- 迭代升级本体规范,回刷历史数据
- 形成「建模-数据-应用-迭代」的闭环
10 前沿技术趋势:AI 大模型时代的新融合
10.1 神经符号融合
知识图谱嵌入(TransE、RotatE)结合本体先验约束,解决纯向量模型语义模糊问题。
10.2 图神经网络 GNN
R-GCN、GAT 等模型,基于本体层级约束优化节点分类、关系预测精度。
10.3 LLM + KG 深度融合(Graph RAG)
- 知识图谱/本体:解决大模型幻觉、不可解释、知识滞后问题
- 大模型:解决图谱构建成本高、语义理解弱、自然语言交互差问题
10.4 多模态知识图谱
将图片、视频、3D 模型纳入知识体系,扩展本体多模态属性约束,突破纯文本知识局限。
10.5 时序知识图谱 + 动态本体
解决知识随时间演化的问题,支持概念定义迭代、时序事实追溯。
10.6 联邦知识图谱
基于统一本体契约,实现多机构数据隐私互通、协同推理,适配政企跨组织协作场景。
11 九大常见误区深度澄清(避坑指南)
- ❌ 误区:本体就是分类树。✅ 正解:分类树只有层级,本体包含关系、属性、公理、约束、推理规则
- ❌ 误区:知识图谱 = 图数据库。✅ 正解:图数据库是存储工具,知识图谱是「知识建模 + 数据 + 推理 + 应用」的完整体系
- ❌ 误区:有本体就等于数据高质量。✅ 正解:还需要 SHACL 校验、实体对齐、冲突消解、人工巡检多重保障
- ❌ 误区:本体推理太慢,生产不可用。✅ 正解:OWL EL/QL、增量推理、查询重写可完全适配大规模生产场景
- ❌ 误区:必须建好完整本体才能做图谱。✅ 正解:最小可行本体快速落地,迭代优化才是工程正道
- ❌ 误区:RDF 比属性图更先进。✅ 正解:场景互补,互通优先,无代际优劣
- ❌ 误区:大模型可以替代知识图谱和本体。✅ 正解:大模型擅长生成理解,图谱 + 本体擅长事实保真、逻辑可控,二者互补不可替代
- ❌ 误区:本体是一次性工作。✅ 正解:本体需要随业务、数据、场景持续版本迭代
- ❌ 误区:图谱数据越多,效果越好。✅ 正解:无规范的海量脏数据,会彻底摧毁智能应用效果
12 工程落地决策树(项目选型直接套用)
12.1 场景决策逻辑
按下面这张决策树走,直接锁定适合你的架构方案:
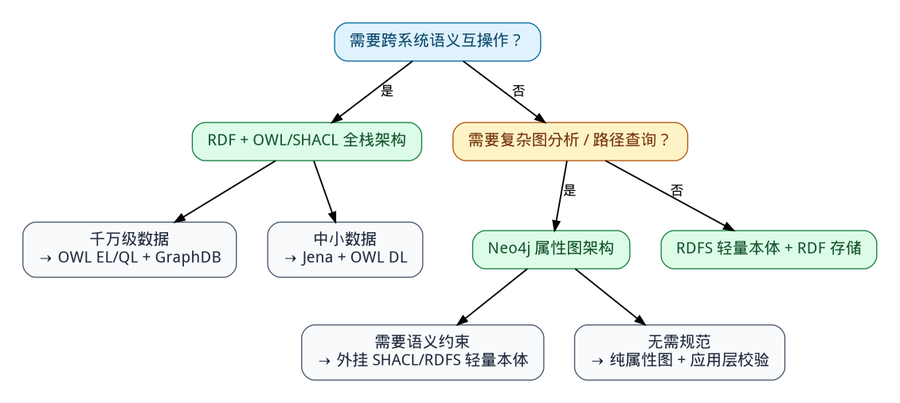
12.2 分阶段投入标准
- POC 验证:轻量 RDFS 本体,10 万级实体快速验证
- MVP 上线:OWL EL 本体 + SHACL 质量门禁,百万级实体
- 规模化运营:模块化本体 + 版本管理,千万级实体
- 生态开放:完整 OWL 标准,联邦知识互通
13 跨领域实战对照表(医学/金融/电商)
| 维度 | 医学健康领域 | 金融科技领域 | 电子商务领域 |
|---|---|---|---|
| 标准本体 | SNOMED CT 医疗本体 | FIBO 金融标准本体 | Schema.org/GoodRelations |
| 核心约束 | 疾病-症状绑定、药物禁忌冲突校验 | 交易实体合法性、风险敞口正数约束 | 商品价格非负、评分 1-5 区间约束 |
| 图谱实例 | 患者诊断、用药、基因、过敏记录 | 股权穿透、担保链路、风控关联 | SKU 属性、品牌、搭配购买、用户评价 |
| 典型推理 | 药物冲突检测、疑似疾病推断 | 隐性关联交易、集团风险测算 | 商品推荐、虚假评价识别 |
| 技术栈 | GraphDB + OWL EL + SHACL | Neo4j + 规则引擎 + 图算法 | 自研图引擎 + Schema 标注 |
全文总结
本体论是知识的语法,知识图谱是知识的语料。
没有本体的知识图谱,是无规则的噪声数据,规模越大、错误越多、治理越难;没有知识图谱的本体论,是无内容的空洞框架,无法落地业务、产生价值。
在大模型 RAG、行业知识库、企业智能体系落地中,本体负责「守逻辑、定规范、保准确」,知识图谱负责「载数据、做关联、撑应用」。
二者双向演化、相辅相成,是当下人工智能从「概率生成」走向「逻辑可控、事实可溯、精准智能」的核心基石。